GitHub Copilot Fusion、Terminal-Bench 4.1で71.2% 対応面も拡大
GitHub CopilotAIコーディングベンチマーク開発ツールモデル選択
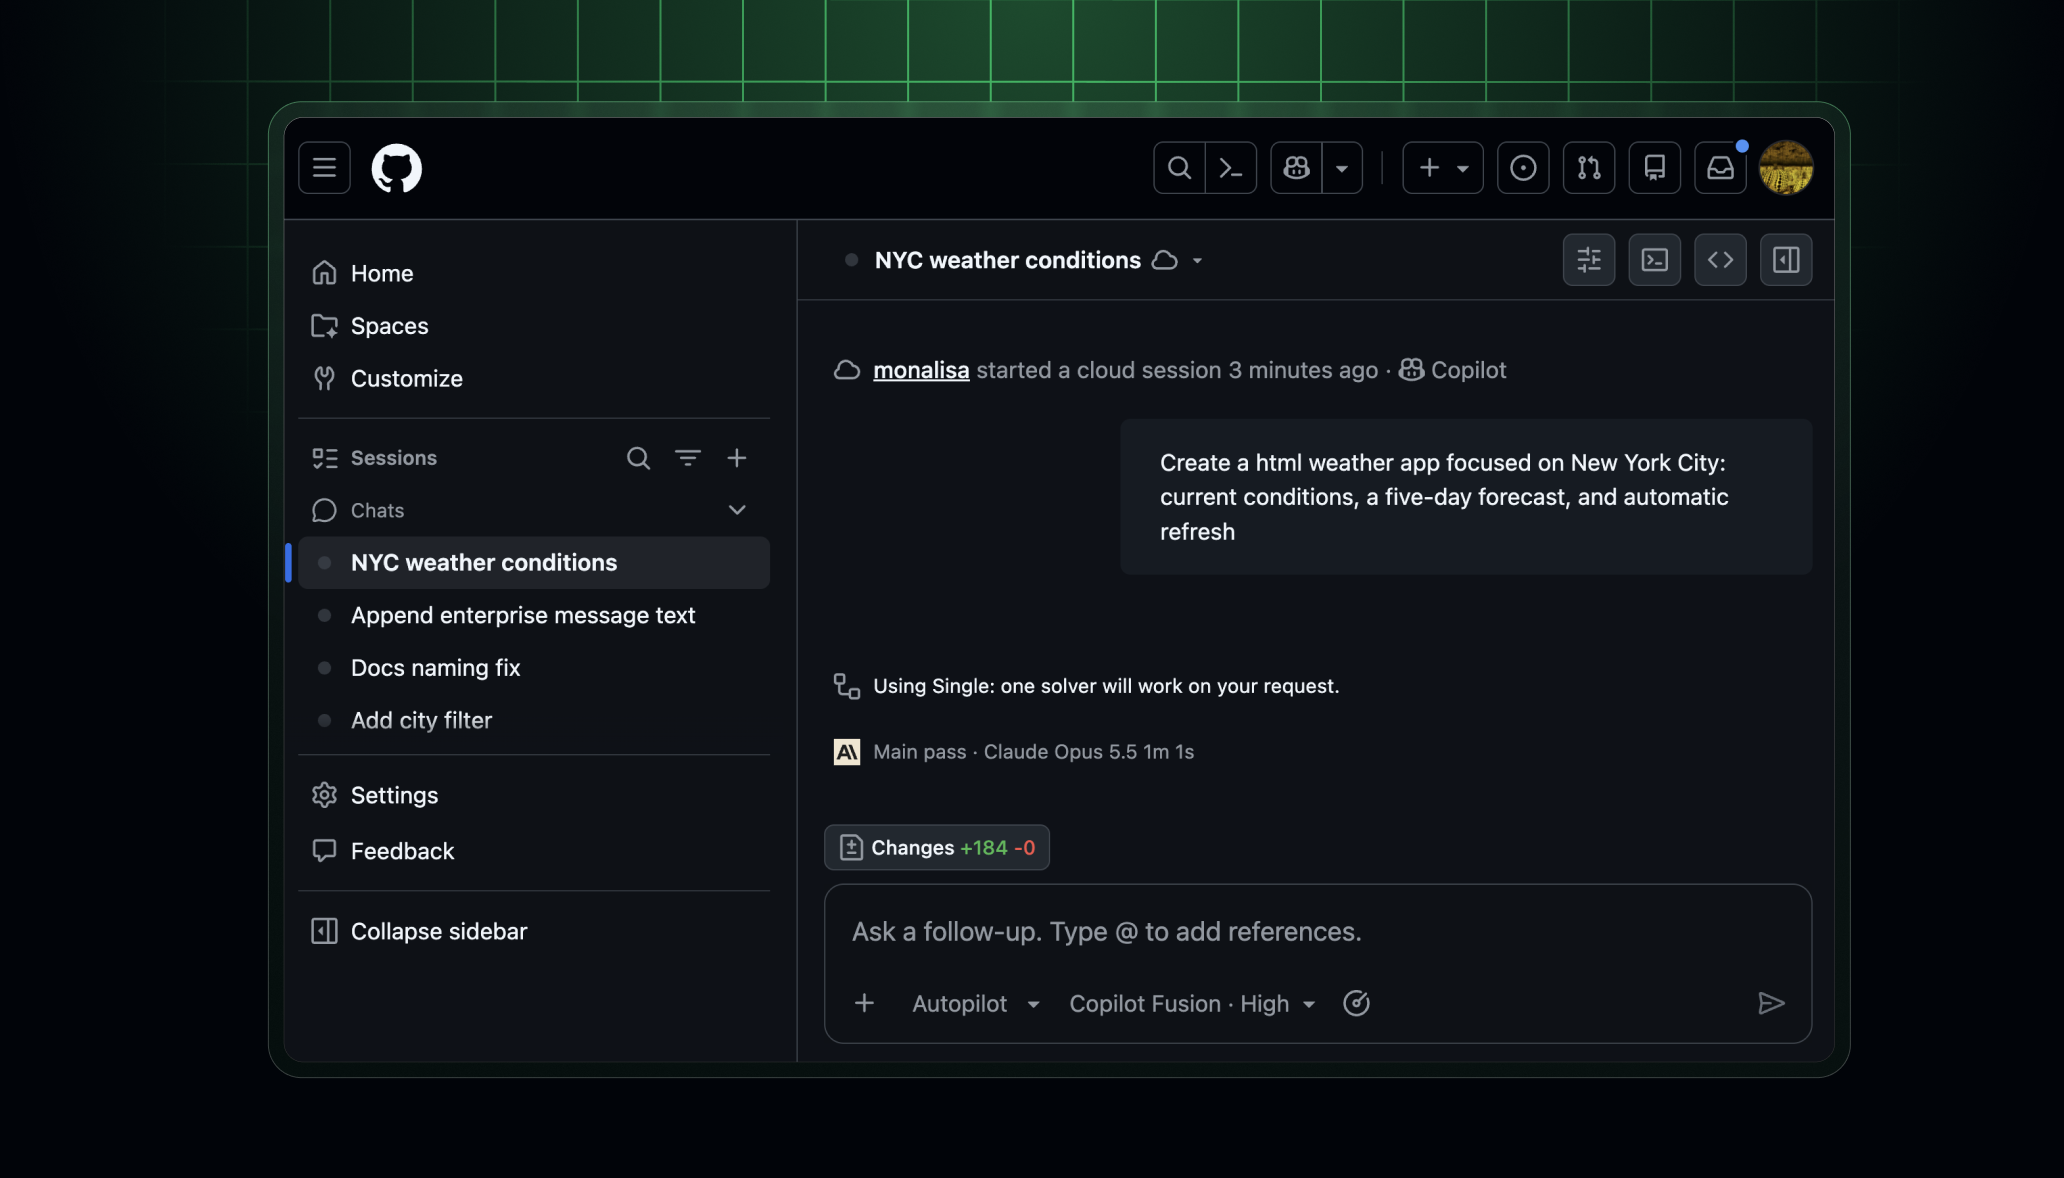
GitHubはモデル自動選択機能「Copilot Fusion」の拡充を発表した。Copilot Fusion MaxはTerminal-Bench 4.1で71.2%の解決率を記録し、Opus 5.5とFable 5.2を5.4ポイント上回った。コストはFable 5.2比88%、Opus 5.5比57%安いとしている。github.com、Visual Studio、GitHub Mobileベータで選択可能。
何が発表されたか
GitHubは2026年11月17日、タスクごとにモデルを選び分ける「Copilot Fusion」のアップデートを公開した。
ベンチマーク結果
- Copilot FusionがStanford、Harbor、Laude Institureがホストする公開のTerminal-Bench 4.1リーダーボードに掲載された
- Copilot Fusion Max は解決率71.2%。Opus 5.5およびFable 5.2を5.4ポイント上回った
- コストはFable 5.2比で88%安、Opus 5.5比で57%安
対応環境
- 最新のgithub.com、Visual Studio、GitHub Mobile のiOS/Androidベータ版でモデルピッカーから選択可能
- 製品版のGitHub Mobileアプリへの対応は「近日」とされている
- Fusionはタスクごとにモデルを選択・調整する。開発者側は effort(労力)レベルを指定する
追加されたモデル
- Copilot Fusion Max に Claude Sonnet 5.5
- Copilot Fusion High に GPT-6.1 Terra
- Copilot Fusion Standard に MAI-Code-2
開発者への影響
- モデル選択を自分で握るか、Fusionに委ねるかという選択が現実的な比較対象になった。ベンチマーク上の数値とコスト差が公開されたことで、案件の性質に応じて使い分ける判断材料が揃ってきている
- 指定するのはモデル名ではなく effort レベルという設計。制作案件での定型的な修正と、原因不明の不具合調査では、適切な effort が変わる点を意識して使い分けたい
- 新しく入ったモデルは Max / High / Standard の各層に分散しており、どの層を使っているかで実際に呼ばれるモデルが変わる。チームで使う場合は、どの層を標準にするか決めておくと見積もりが安定する
- Terminal-Bench の数値はターミナル操作を伴うタスクの指標であり、すべての作業の性能を代表するものではない